


Sommaire
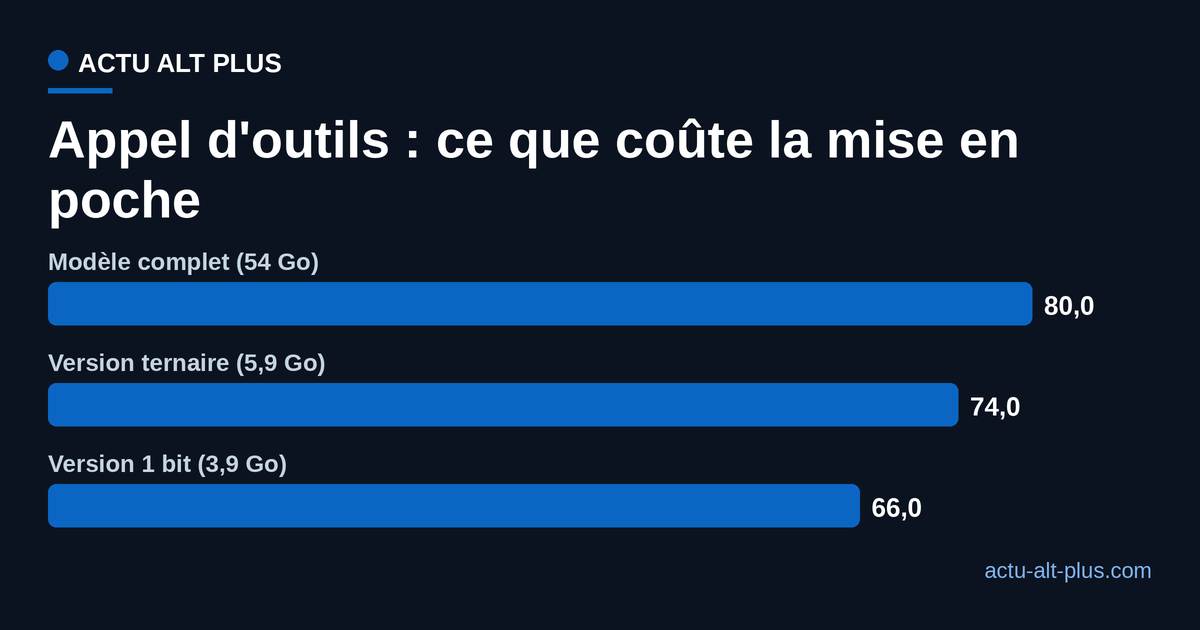
Onze tokens par seconde. C’est le débit mesuré par le laboratoire américain PrismML pour un modèle d’intelligence artificielle qui tourne entièrement dans un iPhone 17 Pro Max, sans réseau, sans compte, sans serveur. Le même modèle occupait 54 Go dans sa version d’origine. Il en occupe 3,9 depuis le 14 juillet. Et son prix est écrit noir sur blanc dans les tableaux du laboratoire : sur quinze tests de référence, le score global tombe de 85,0 à 76,1, et la capacité à piloter des outils s’effondre de 80,0 à 66,0.
Ce que « 3,9 Go » veut dire quand vous ouvrez une application
Un modèle d’IA doit être chargé en entier dans la mémoire vive de la machine qui le fait tourner, comme un livre qu’il faudrait poser ouvert sur la table avant d’en lire la moindre ligne. Tant que le livre déborde de la table, rien ne se passe.
La table d’un téléphone est minuscule. PrismML le dit sans détour : un iPhone doté de 12 Go de mémoire n’en offre qu’environ 6 à une application, et le modèle partage encore ce budget avec tout ce qu’il fabrique en cours de route. À 3,9 Go, le livre passe. À 17,6 Go, poids de la version compressée classique du même modèle, il ne passe pas. À 54 Go, il faut un serveur.
Concrètement : dicter une note, traduire un paragraphe, résumer un contrat photographié, tout cela peut désormais se faire dans l’avion, dans le métro, ou simplement sans que le texte parte quelque part. Ce n’est pas une question de vitesse. C’est une question de trajet.
Un bit par poids, ou l’art de jeter les décimales
Le mot « paramètres » fait peur, il désigne pourtant quelque chose de simple : les 27 milliards de petits nombres qu’un modèle a appris pendant son entraînement, et qu’il consulte pour produire chaque mot. Chacun de ces nombres était jusqu’ici stocké sur 16 bits, avec ses décimales. Vingt-sept milliards de nombres à 16 bits, cela fait 54 Go.
La méthode de PrismML consiste à réduire chaque nombre à son signe : plus ou moins. Une seule information binaire par paramètre, au lieu de seize. Le laboratoire annonce 1,125 bit effectif par poids, ce qui donne 3,9 Go et une division par 14 environ. Une seconde variante, dite ternaire, garde trois valeurs possibles au lieu de deux, pèse 5,9 Go et vise les ordinateurs portables plutôt que les téléphones. Les deux sont publiées sous licence libre Apache 2.0 et téléchargeables gratuitement.
Le laboratoire revendique le premier modèle de cette catégorie de puissance à tourner sur un téléphone, une affirmation qui reste, à ce stade, la sienne.
Le prix de la compression, que personne ne met en avant
Les reprises de l’annonce s’arrêtent au poids. Le tableau publié par PrismML raconte pourtant une seconde histoire. Sur les quinze tests, la version d’origine obtient 85,0, la ternaire descend à 80,5, et celle du téléphone tombe à 76,1.
La perte n’est pas répartie au hasard. Les mathématiques tiennent presque (95,3 contre 91,7) et le code résiste plutôt bien (88,7 contre 81,9). Mais dès qu’il s’agit de manipuler des outils et d’enchaîner des actions, bref de faire le travail que l’on attend d’un assistant, l’écart devient net.
Reprendre ce graphique ou citer ce chiffre
Citez ce chiffre en mentionnant Actu Alt Plus :
Ou réutilisez ce graphique librement sur votre site, attribution incluse :
Quatorze points perdus sur l’appel d’outils, c’est beaucoup pour la fonction dont le laboratoire fait précisément l’argument de vente. La vision recule elle aussi, de 72,6 à 59,6. Autrement dit, le modèle qui tient dans votre poche est le même que celui du serveur, mais il se trompe plus souvent, et il se trompe surtout là où il agit.
Ce qui change vraiment, c’est le trajet de vos données
Le vrai basculement n’est donc pas la performance, c’est la géographie. Quand vous posez une question à un assistant en ligne, votre phrase quitte l’appareil, traverse le réseau, atterrit dans un centre de données. Un modèle embarqué supprime ce voyage par construction : il n’y a pas de politique de confidentialité à lire, parce qu’il n’y a pas de destinataire.
La facture énergétique suit le même chemin. Nous avons déjà détaillé le coût d’une requête IA et la difficulté à le mesurer. PrismML avance 0,275 milliwattheure par token sur un ordinateur portable, contre 0,63 à 1,32 pour les processeurs de centre de données. Chiffres du laboratoire, pas d’un audit indépendant : un ordre de grandeur, pas une preuve.
Reste la limite honnête, que le laboratoire écrit lui-même dans sa fiche technique : sur un téléphone, la chaleur brise l’élan. Les onze tokens par seconde correspondent au démarrage à froid ; une génération continue redescend à 10,8, et vide 1 % de batterie tous les 672 tokens.
Pendant deux ans, la course s’est jouée sur la taille des modèles et des centres de données qui les hébergent, et les classements mensuels ont sacré les plus gros. Une autre course commence, dans l’autre sens : celle de l’intelligence par gigaoctet. Un modèle à 76 sur 100 qui ne parle à personne vaut-il mieux qu’un modèle à 85 qui parle à un serveur ? La réponse n’est pas technique. Elle dépend de ce que vous lui confiez.
Votre réaction :
Article créé en collaboration avec l’IA.
Les plus lus
- 1
 Taratata 600 : la date d’enregistrement et celle de diffusion
- 2
 Résultat du Super Loto du 18 septembre : 13 millions gagnés
- 3
 Steam Frame, 72 heures pour acheter après le tirage au sort
- 4
 Nouveau félin : le tilcayo, premier chat décrit depuis un siècle
- 5
 Résultats des évaluations nationales 2026, dès le 21 septembre
Nos dossiers
- France395
- Science272
- Culture193
- Consommation173
- Patrimoine165
- Santé publique162
- IA162
- Sport159
Recevez notre sélection dans votre boîte mail
Le meilleur d’Actu Alt Plus : décryptages, chiffres et panoramas. Désinscription en 1 clic, zéro spam.
